
İnsansı Robotlar İnsanlardan Nasıl Öğreniyor – Videolar Ne Öğretebilir, Ne Öğretemez?
Son güncelleme: 24 Eylül 2026; atıf yapılan en güncel bulgu 19 Eylül 2026 tarihlidir.
1. Giriş
Bu yazıda, insansı robotların insanları iş başında gösteren videolardan nasıl öğrendiğini inceleyeceğiz. Giderek daha fazla şirket, insanların günlük işlerini kaydedip bu görüntüleri eğitim verisi olarak kullanıyor. Böylece genellikle daha yavaş veya daha pahalı olan alternatifleri — teleoperasyonu (uzaktan kontrol), simülasyonu ya da robotun kendi deneme yanılma süreciyle öğrenmesini — destekliyor veya bunlara duyulan ihtiyacı azaltıyor. Video tek başına yeterli olmasa ve gerçek deneyim hâlâ önem taşısa da videolar bir robota çok şey öğretebiliyor.
2. Eğitim sürecinin ana hatları
Süreç kabaca şu şekilde: İnsanlar bir şeyler yaparken videoya kaydedilir. Ardından tekrarlanan veya kullanılamayan görüntüler çıkarılır ve geriye ayıklanmış bir video koleksiyonu kalır. Buna veri kümesi denir. Veri kümesi, verilerden öğrenen ve sonunda robotu kontrol edecek olan yapay zekâ sistemini, yani modeli eğitmek için kullanılır. Model henüz gerçek bir robotla çalışmadan, veri kümesi üzerinde yapılan bu ilk eğitim aşamasına ön eğitim (pretraining) denir. Model, nesnelerin nasıl hareket ettiği ve ellerin nesneleri nasıl kavradığı gibi yararlı örüntüleri ön eğitim sırasında videolardan öğrenir. Bu aşamada öğrendikleri henüz belirli bir robota özgü değildir.
Sonra uyarlama gelir: Model, belirli bir robot üzerinde daha fazla eğitilerek o robotun gerçek gövdesini ve sensörlerini öğrenir. Uyarlamanın ardından robot kullanıma alınır ve kendisi de daha sonraki eğitimlerde kullanılabilecek deneyimler edinmeye başlar. Bu süreç, robot hareket ederken çalışan kontrol sisteminden ayrıdır (Bölüm 8).
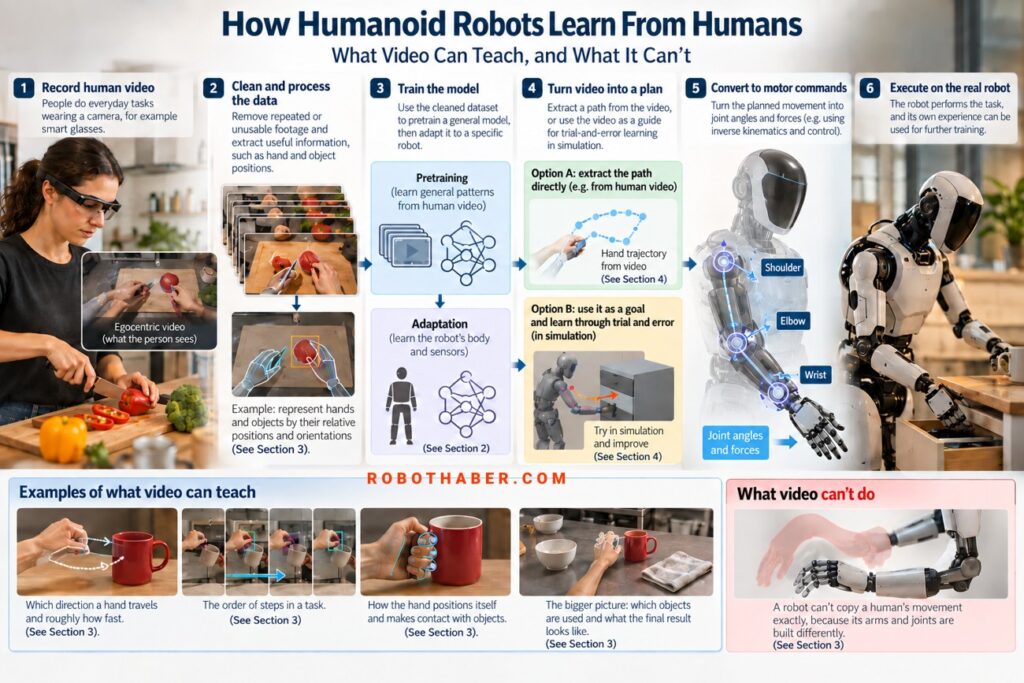
3. Video ne öğretebilir?
Bir video, insanların nasıl hareket ettiğine ilişkin robota çok şey gösterir: Bir elin hangi yöne gittiğini, yaklaşık hızını, adımların sırasını ve vücudun nasıl konumlandığını. Ancak robotun kolları ve eklemleri genellikle insanınkilerle aynı yapıda olmadığından, insan hareketini bütün eklem açılarıyla birebir kopyalamasını sağlayamaz. Video, görevin genelini de gösterir: Kişinin hangi nesneleri kullandığını, nerelerde temas kurduğunu ve sonuçta ortaya ne çıktığını. Yine de robot, insanın yaşadığı deneyimi değil, yalnızca bunun videosunu görür. Yakın tarihli bir deney, videonun tek başına ne kadar işe yarayabileceğini gösteriyor.
Örnek: El ile nesne arasındaki geometri (HumanEgo, Maryland Üniversitesi, Haziran 2026). Maryland Üniversitesinden bir ekip, bir robota bir görev öğretmek için ne kadar az insan videosunun yeterli olacağını görmek istedi. Bir kişi akıllı gözlük takarak elleriyle bir görev yaparken kendini kaydetti; süreçte hiçbir robot yoktu. Ekip daha sonra insanın kolunu videodan dijital olarak sildi ve elleri ve nesneleri, birbirlerine göre konum ve yönelimleriyle temsil etti. Bunu, göreve özgü herhangi bir robot eğitimi olmadan robota aktardı. Robot, görev başına yalnızca 30 dakikalık videoyla dört gerçek ortam görevinde denemelerin %92,5’inde başarılı oldu.¹,²
4. Videodan bir hareket yolu çıkarma
Video, bir insanın ne yaptığını gösterir; ancak robotun daha somut bir şeye ihtiyacı vardır: Gerçekte nasıl hareket edeceğini belirleyen bir hareket yoluna, bir plana. Bazı yöntemler bu yolu doğrudan videodan çıkarır. Diğerleri videoyu yalnızca bir ipucu veya hedef olarak kullanır ve robotun kendi yolunu deneme yanılmayla bulmasını sağlar. Aşağıdaki iki örnek bu yaklaşımları gösteriyor.
Örnek: Sıradan videolardan elin izlediği hareket yolları (VidBot, 2025). Münih Teknik Üniversitesi ve ETH Zürih’teki araştırmacılar, sıradan bir videoyu izleyip insan elinin izlediği yolu çıkaran ve bunu robotun takip edebileceği bir harekete dönüştüren VidBot sistemini geliştirdi. Sistem, simülasyonda 13 görev boyunca kendisinden sonra gelen en başarılı yöntemin oldukça önünde sonuç aldı. Ayrı bir değerlendirmede gerçek bir robot üzerinde de test edildi.³
Örnek: Ödül sinyali sağlayan video (Human2Sim2Robot, 2025). Stanford Üniversitesindeki araştırmacılar, tek bir videodan iki bilgi çıkaran Human2Sim2Robot sistemini geliştirdi: Nesnenin izlediği yol ve nesneyle etkileşim başlamadan hemen önce elin aldığı poz. Robot, bu iki ipucunu rehber olarak kullanıp bilgisayar simülasyonunda kendi hareket yolunu deneme yanılmayla buluyor. Sistem, yalnızca bir videoyla, kaydedilen hareketi basitçe tekrar eden bir karşılaştırma yöntemini %55’ten fazla; standart bir taklit ederek öğrenme yöntemini ise %68’den fazla geride bıraktı.⁴
5. Hareket yolundan motor komutuna
Bir elin veya kolun hangi yolu izlemesi gerektiğini bilsek bile robotun bunu, hareketin içindeki her eklem için motor komutlarına dönüştürmesi gerekir: Eklemin ne kadar döneceği ve ne kadar kuvvet uygulanacağı belirlenmelidir.
“Ne kadar dönecek?” sorusu için yaygın tekniklerden biri ters kinematiktir (inverse kinematics); ancak her sistem bunu bu yolla çözmez. Ters kinematikte, elin, ayağın veya başka bir parçanın ulaşması istenen konumdan geriye doğru gidilerek omuz, dirsek, diz ve yol üzerindeki diğer eklemlerin hangi açılarda olması gerektiği hesaplanır. Hedef hareket ettikçe bu hesap sürekli yeniden yapılabilir.
Ancak açılar tek başına yetmez. Motorun ne kadar kuvvet uygulayacağını da bilmesi gerekir. Bu, robotun kendi kolunun ağırlığına, eklemlerindeki sürtünmeye ve nesnede karşılaştığı dirence bağlıdır: Bir şeyi tutmak için ne kadar sıkması gerektiğine veya bir yüzeyin ona ne kadar kuvvetle karşılık verdiğine. Video burada da sınırlarına ulaşır. Bir kişinin bardağı tuttuğunu gösterebilir, ancak ne kadar sıkı tuttuğunu veya bardağın kayıp kaymadığını gösteremez. Robotun bunları kendi sensörleriyle algılaması gerekir.
Kameralar da bu noktada zorlanır: Başa takılan bir kameranın çektiği videoda el, temas noktasının görüntüsünü sık sık kapatır. Robotun fiziksel sınırları da yeniden devreye girer: İnsan vücudu için uygun bir hareket yolu, robotun bir ekleminin tasarlandığından daha fazla bükülmesini veya daha hızlı hareket etmesini gerektirebilir.
Örnek: Simülasyonda teması öğrenme. Carnegie Mellon Üniversitesindeki araştırmacılar, 2025’te HDMI (HumanoiD iMitation for Interaction) adlı bir sistem geliştirdi. Sistem, insanın ve nesnenin hareketlerini videodan alıyor. Ardından robot, fizik simülasyonunda ayrı olarak pratik yapıp temas kurmayı ve dengesini korumayı deneme yanılmayla öğreniyor; arada ek bir eğitim olmadan doğrudan gerçek robota aktarılıyor. Gerçek bir Unitree G1 insansı robot üzerinde yapılan testlerde sistem, art arda 67 kapıdan geçmeyi ve yürümeyle nesne kullanımını birleştiren altı görevi başardı. Video ne olması gerektiğini gösterdi; temas ve denge davranışı ise simülasyonda pekiştirmeli öğrenme (reinforcement learning) yoluyla öğrenildi.⁵
6. Robotun kendi deneyimine çoğunlukla hâlâ ihtiyaç var
İnsan videoları, robota özgü ne kadar veri gerektiğini azaltabilir. Yukarıdaki HumanEgo örneği, sınırlı bir görev grubu için göreve özgü robot eğitimi ihtiyacını bazen tamamen ortadan kaldırabildiğini gösteriyor. Ancak robotun komutlarının gerçek harekete nasıl dönüştüğü, zamanlama, denge ve hatalardan sonra toparlanma gibi videonun öğretemediği şeyler için genellikle robota özgü bir miktar veri gerekiyor.
Örnek: İnsan videolarını eğitime katma (Physical Intelligence, Aralık 2025). Physical Intelligence araştırmacıları, genel amaçlı robot yapay zekâ modelleri π0.5’in ek eğitimine, yani ince ayarına (fine-tuning), insanın kendi bakış açısından çekilmiş videolar ekledi. Bu, yalnızca insan videolarında görülen dört yeni durumda performansı yaklaşık iki katına çıkardı; insan hareketleriyle robot hareketleri arasında açıkça tanımlanmış bir eşleştirme de gerekmedi. Ancak bu, model önce çok çeşitli robot ortamları ve görevleri üzerinde eğitildikten sonra işe yaradı. İnsan videoları bu temele eklendi; onun yerini almadı.⁶
Örnek: Kontrol için insan hareketi, beceriler için teleoperasyon (HumanPlus, CoRL 2024). Stanford Üniversitesindeki araştırmacılar önce bir sistemi, mevcut 40 saatlik insan hareketi verisiyle simülasyonda eğitti. Bu sayede insansı robot, tek bir kamera kullanarak bir kişinin hareketlerini gerçek zamanlı taklit edebildi; buna hareketleri izleyerek taklit etme (shadowing) deniyor. Operatörler daha sonra bu yeteneği robotu uzaktan kontrol etmek (teleoperasyon) ve gerçek görev gösterimlerini kaydetmek için kullandı. Bu gösterimleri davranış klonlama (behavior cloning) yoluyla öğrenen robot, bir sweatshirt’ü katlamak gibi beceriler edindi ve en fazla 40 gösterimle denemelerin %60–100’ünde başarılı oldu.⁷
Bu tür sistemlerde kullanılan insan videosu miktarı 30 dakikadan bir milyon saatin üzerine kadar çıkıyor. Hâlâ ihtiyaç duyulan robota özgü veri miktarı da aynı ölçüde değişiyor.
7. Daha fazla insan videosu gerçekten işe yarıyor mu?
İki örnek kabaca şu yanıtı veriyor: Evet, ancak bilinmesi gereken önemli sınırlar var.
Örnek: Veri miktarını kademeli artırma (Dyna-2, Ağustos 2026, şirketin bildirdiği sonuçlar). Dyna Robotics araştırmacıları, modelleri 1.000 saatten bir milyon saatin üzerine kadar giderek artan miktarlarda insan videosuyla eğitti. Ardından her sürüme aynı miktarda, görev başına en fazla 10 saatlik robot pratiği yaptırdı. Video miktarı arttıkça 14 görevdeki ortalama başarı düzenli olarak yükseldi: %20, %28, %45 ve %53. Ancak tek tek görevlere bakıldığında tablo daha karmaşıktı. Bir görevde (kilitli bir kutuda anahtar çevirme) başarı, en büyük veri miktarında birden %90’a çıkana dek %0’da kaldı. Başka bir görevde (ip bağlama) ise %90’dan %40’a düştü. Görev başına yalnızca 10 deneme yapıldığından bu düşüşün nedeni belirsiz. Yalnızca 10 dakikalık robot pratiği gerektiren bir görevde bile video miktarı arttıkça başarı %10’dan %50’ye çıktı. Her görevde yine bir miktar robot pratiği kullanıldı. Dolayısıyla bu sonuç, videonun robotu zaten öğrenmekte olduğu görevlerde geliştirdiğini gösteriyor; robotun yalnızca video izleyerek tamamen yeni işler öğrendiğini değil.⁸
Örnek: Sıfırdan başlamak ile video eğitiminden başlamak (Figure Helix 2.5, 17 Eylül 2026, şirketin bildirdiği sonuçlar). Figure, Helix 2.5 modelini kendi video veri kümesiyle eğitti; ardından modele üç ev işi öğretti: ortalığı toplama, havlu katlama ve yatak yapma. Video eğitiminin gerçekten yardımcı olup olmadığını görmek için robotun iki sürümünü, daha önce hiçbirinin görmediği 30 evde karşılaştırdı. Her ikisi de bu görevlerde aynı miktarda uygulamalı pratik yapmıştı. Tek fark, sürümlerden birinin video eğitimi almadan sıfırdan başlaması, diğerinin ise video eğitimi almış modelden başlamasıydı. Sıfırdan başlayan sürüm denemelerin %9’unda, video eğitimi almış sürüm ise %56’sında başarılı oldu.⁹
8. Videodan öğrenme ve robot kontrol sistemleri
Buraya kadar anlatılanların — robotun videodan çıkardığı hareket yolunun (Bölüm 4), bu yolu izlemek için gereken motor komutlarının ve kuvvet algılamasının (Bölüm 5) — robot hareket ederken canlı olarak çalışması gerekir. Bu, robotun kontrol sisteminin işidir ve önceden öğrenilenlerden gerçekten farklı bir süreçtir. Videodan öğrenme, bazen birkaç aşamadan oluşan eğitim sırasında gerçekleşir. Kontrol ise robot hareket ettiği sürece, sürekli ve gerçek zamanlı olarak çalışmalıdır.
Bir robotun kontrol sistemini, işin farklı bölümleri çok farklı hızlarda gerçekleştiği için farklı hızlarda çalışan üç katman olarak düşünmek yararlıdır. “Bardağı şu yolu izleyerek al” kararı, nispeten yavaş ve üzerinde düşünülerek verilen bir karardır; belki saniyede yalnızca birkaç kez güncellenir. Bu hız Hz, yani saniyedeki güncelleme sayısıyla ölçülür. Plan kabaca bu katmanda uygulanır. İki ayaklı bir robotun dengesini korumak için saniyede onlarca, hatta yüzlerce kez çalışan daha hızlı bir katman gerekir. Kuvvete, dokunmaya ve vücut konumuna tepki vermek ise en hızlı katmanı gerektirir: Bu katman saniyede yaklaşık 1.000 kez çalışabilir. Bu, vücudun “düşünmeden” yaptığı anlık düzeltmelere benzer.
9. Bildirilen sonuçlar nasıl okunmalı?
Yukarıda başarı oranlarından söz ettik. Bilinmesi gereken iki nokta var:
Her adımı iyi yapmak, işin tamamını bitirmeyi garanti etmez. Örneğin her adımın bağımsız olarak başarılı olduğunu varsayalım. Bir robot 14 adımlı bir görevin her adımında %90 başarı gösteriyorsa 14 adımın tamamını arka arkaya bitirme olasılığı yalnızca yaklaşık %23’tür. Her adımda %99 başarı gösterse bile toplam olasılık yaklaşık %87 olur. Görevin tamamını güvenilir biçimde denemelerin %90’ında bitirebilmesi için her adımda %99’un üzerinde başarı göstermesi gerekir.
Az sayıda test, daha az güvenilir bir oran demektir. Örneğin yalnızca 50 denemede bildirilen “%80 başarı” için gerçek oran yaklaşık %69 ile %91 arasında olabilir. 400 denemede sonuç daha sağlamdır; yaklaşık %76 ile %84 arasında olması beklenir. Testler birbirine çok benziyorsa veya bağımsız değilse gerçek belirsizlik, bu basit hesabın gösterdiğinden daha büyük olabilir.
10. Bütün bu videolar nereden geliyor?
İnsanların çektiği her video aynı ölçüde yararlı değildir. Ham görüntünün toplam süresi, verinin değerini ölçmek için iyi bir gösterge değildir; önemli olan, görüntülerin uygun biçimde ayıklanması sonucunda ne kadar ilgili ve kullanılabilir malzeme kaldığıdır. Bin farklı odadan gelen binlerce saatlik video, robota otomatik olarak bin farklı beceri öğretmez. Figure, Index uygulamasının Ağustos 2026’daki lansmanında saniyede 30 dakikalık video aldığını (şirketin bildirdiğine göre günde yaklaşık 43.200 saat), 16 milyondan fazla videonun yüklendiğini ve içerik sağlayanlara 15 milyon dolar ödendiğini söyledi.¹⁰
Bu verileri toplamak hem pahalı hem de emek gerektiriyor. Günlük işleri gerçekten videoya çekenler, çoğu zaman onlarca farklı ülkedeki insanlar. MIT Technology Review’un aktardığı bir örnekte, bir çalışana saatte 15 dolar ödendi.¹¹ Spirit AI ise Reuters’a, daha geniş bir hareket çeşitliliği içeren farklı ve “kirli” verilerin modellerinin daha hızlı gelişmesine yardımcı olduğunu söyledi.¹²
Kullanılabilir video saati başına maliyet, kaydedilen saat başına fiyatın, ayıklama sonrasında elde tutulan görüntü oranına bölünmesiyle bulunuyor. Örneğin kaydedilen saat başına maliyet 10 dolarsa ve görüntülerin %40’ı kullanılabiliyorsa kullanılabilir saat başına maliyet 25 dolar oluyor.
İnsan videoları, eğitim verisi toplamanın çeşitli yollarından biri. Diğer seçenekler yukarıda belirtildiği gibi robotun simülasyonda pratik yapması, bir insanın robotu doğrudan uzaktan kontrol etmesi veya robotun gerçek dünyada kendi deneme yanılma süreciyle öğrenmesi olarak sayılabilir. Her birinin farklı maliyetleri ve ödünleşmeleri vardır; burada kullanılan kaynakların hiçbiri bunları doğrudan karşılaştırmıyor.
11. Güvenlik, gizlilik ve standartlar
Bir robotun bir şeye ne kadar kuvvetle bastırabileceğini sınırlayan özellikler veya düşmeye başlarsa onu durduran sistemler gibi güvenlik önlemleri, doğrudan donanımına ve kontrol yazılımına yerleştirilir. Robot bunları video izleyerek öğrenmez. İnsanlar günlük yaşamda her şeyi her zaman en güvenli biçimde yapmaz. Dolayısıyla sıradan insan alışkanlıklarını kopyalayan bir robot, iyi alışkanlıkların yanında kötü alışkanlıkları da kopyalayabilir. İnsan benzeri robotlara yönelik resmî güvenlik standartları henüz tam olarak mevcut değil; ilgili uluslararası kurallar hâlâ hazırlanıyor.
Evlerde çekilen videolar gizlilik sorularını da gündeme getiriyor. Bu videolar çoğu zaman yalnızca görevi yapan kişiyi değil, arka plandaki başka insanları, çocukları ve kişisel belgeleri de kaydediyor. Görüntülerin sonunda nasıl kullanıldığı, paylaşıldığı veya saklandığı ya da videoyu çekenlerin görüntülerin nereye gittiğini tam olarak anlayıp anlamadığı her zaman açık değil.
Sonuç
Amaç kusursuz taklit değildir. Amaç, robotun fiziksel dünyayla ilgili her şeyi yalnızca maliyetli deneme yanılma süreçleriyle yeniden keşfetmek zorunda kalmaması için ona makul bir başlangıç noktası sağlamaktır. İnsan videoları; görevler, nesneler ve hareketler hakkında geniş bir ön bilgi sunmanın yollarından biridir. Ancak video, insanların fiziksel becerileri nasıl öğrendiğinin yalnızca bir bölümünü yansıtır. Biz de yalnızca izleyerek değil, üç boyutlu dünyayı kendi duyularımızla hissedip doğrudan deneme yanılma yoluyla çok şey öğreniriz. Her durumda robotun, videonun tek başına öğretemediği kuvvet uygulama, temas kurma, denge ve kontrol becerilerine de ihtiyacı vardır. Bunları gerçek dünyada veya simülasyonda kendi pratiğiyle öğrenir.
Kaynaklar
- HumanEgo (arXiv 2605.24934)
- Maryland Üniversitesinin HumanEgo duyurusu (3 Haziran 2026)
- VidBot (CVPR 2025): arXiv özeti · tam metin (PDF) · CVPR sayfası
- Human2Sim2Robot (CoRL 2025)
- HDMI (arXiv 2509.16757)
- Physical Intelligence: insandan robota aktarım (Aralık 2025)
- HumanPlus (CoRL 2024)
- Dyna Robotics: Dyna-2 (Ağustos 2026)
- Figure: Helix 2.5 (17 Eylül 2026)
- Figure: Index’in tanıtımı (25 Ağustos 2026)
- MIT Technology Review: insansı robotları eğiten geçici çalışanlar (1 Nisan 2026)
- Reuters: Spirit AI röportajı (18 Eylül 2026)

İnsansı Robotlar İnsanlardan Nasıl Öğreniyor added by editor on
View all posts by editor →
Yorum yapabilmek için kayıtlı kullanıcı olmanız gerekmektedir. Giriş